中美AI競爭,比的是限制對手能力
中國已經建立自己的模型研發能力,卻仍有誘因利用美國最前沿模型降低部分研發與試錯成本;美國則開始把防線從晶片延伸到模型能力。這場競爭的核心,正在變成誰能讓自己的能力更難被對手取得,同時降低自己追趕前沿能力的成本。
中國已經建立自己的模型研發能力,卻仍有誘因利用美國最前沿模型降低部分研發與試錯成本;美國則開始把防線從晶片延伸到模型能力。這場競爭的核心,正在變成誰能讓自己的能力更難被對手取得,同時降低自己追趕前沿能力的成本。
吳子嘉/分析報導
一、1.51億次
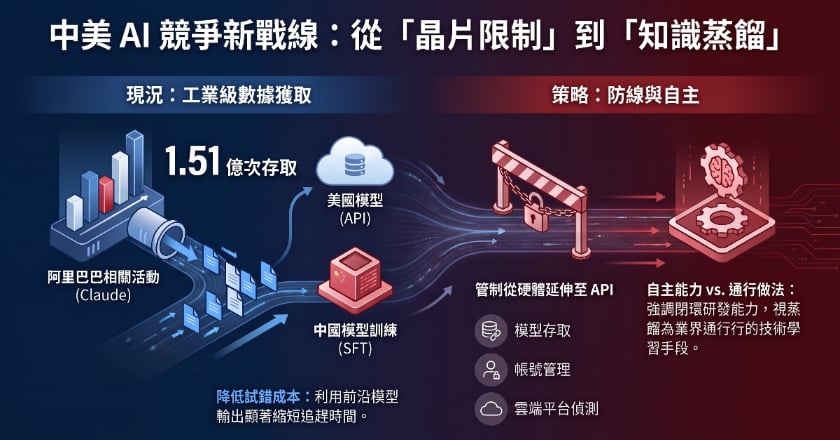
Anthropic在9月10日的報告中稱,2026年5月至7月間,與阿里巴巴/通義千問相關的活動向Claude發出超過1.51億次exchange,高峰時單日接近300萬次。同一份報告分別列出月之暗面2,300萬次以上、深度求索1,210萬次以上、智譜340萬次以上、小米40萬次以上——這是五家公司各自的獨立歸因,不是一個可以相加的總數。
這些數字本身無法單獨證明什麼。真正值得問的是:這些流量被拿去做了什麼。Anthropic的描述不只是問答紀錄——它稱在阿里巴巴的案例中,Claude輸出被轉成SFT訓練資料,用於通義千問系列模型,並協助RL環境建置與模型架構研究。這已經超過一般理解的「查資料」。
二、中國不是不會做AI
但如果因此推論「中國AI靠美國模型撐起來」,證據並不支持。
深度求索自己公開的技術路徑顯示,R1-Zero直接從base model透過大規模強化學習產生推理能力,之後再由R1自身生成資料,去蒸餾出六個較小模型——這是一條完全內部閉環的能力鏈。通義千問的旗艦模型同樣不是靠外部teacher走完整訓練:它公開的方法是自有的Long-CoT、Reasoning RL與Thinking Mode Fusion,較小模型才使用strong-to-weak distillation,而teacher是通義千問自己的模型。Kimi、小米的MiMo、智譜的GLM也都各自公開了規模可觀的自有預訓練與強化學習體系。
換句話說,中國大型AI公司已經具備相當完整的自主模型訓練能力。「沒有Claude就做不出前沿模型」這個命題,現有證據並不成立。
三、既然自己會做,為什麼還要大量取得美國模型輸出?
問題因此變成:能力已經有了,為什麼還要這麼大規模地取得Claude的輸出?
OpenAI向美國國會提交的文件,也從自己的平台觀察到深度求索及其他中國來源的蒸餾活動,並描述這類操作已不只是單純取得模型回答,而是朝更複雜的資料生成與處理流程發展。這不是轉述Anthropic的說法,而是另一家前沿模型公司自己的平台觀察。
一個合理的解釋是:即使已經有自己的teacher,使用更強的外部模型,仍可能在特定能力上降低試錯成本、取得更高品質的推理與程式資料、縮短逼近前沿的時間。但必須誠實承認一件事——這些美國模型輸出在中國公司整體訓練資料與能力提升中,究竟佔多少比重,目前沒有任何公開的比例數據,也沒有可靠的對照實驗。無法說「Claude讓通義千問提前半年」,也無法說「拿掉Claude,中國會明顯落後」。這是整個問題目前最大、也最誠實的空白。
四、美國開始封的不是晶片,而是能力
美國的政策反應,正好呼應了這個轉變。
白宮4月23日的NSTM-4寫道,美方掌握資訊顯示,主要位於中國的外國實體正在對美國前沿AI系統進行「蓄意的、工業規模的」蒸餾行動。9月8日,NSA、FBI與CISA聯合公告進一步定性:中國的AI公司正在進行工業規模的蒸餾活動,並刻意將操作分散到多個模型供應商與雲端平台,以規避單點偵測。
這代表管制的對象正在改變。晶片有工廠、封裝、出口、海關這一整套實體流程可以卡關;但模型的輸出,沒有海關。美國因此開始把防線從硬體出口管制,進一步延伸到模型存取、帳號、API、雲端平台以及蒸餾行為本身的偵測與防堵。
五、中國的答案不是停止競爭,而是提高自主程度
面對這樣的指控,中國官方的立場相當一致。商務部9月9日直接回應稱,蒸餾是「各個模型間互相學習的通行做法」,本質是中性技術手段,包括美國企業在內全球都在使用;並將美方的行動定性為把正常技術與商業問題政治化、工具化。這不是9月才出現的立場——7月27日,商務部已就美方可能以「竊取智慧財產權」為由制裁中國AI企業一事,做出類似回應。
與此同時,中國並未因此放慢自主化的腳步——第二段已經看到,幾家主要公司的自有訓練體系都在持續擴大規模。
六、真正比的是什麼?
這不是「誰完全不需要誰」——雙方都還沒有,也可能永遠不會走到那一步。真正在發生的是:中國一邊持續強化自己的訓練體系,一邊仍然有動機取得美國前沿模型的輸出;美國則一邊守住自己的技術優勢,一邊試圖讓這個優勢更難被對手取得。
過去中美AI競爭的敘事,多半停留在誰的模型更強、誰的晶片更先進。但1.51億次這個數字說明,一條新的戰線已經浮現:誰能把自己的能力留得更久,又能更快吸收對方的進步。
吳子嘉/分析報導
一、1.51億次
Anthropic在9月10日的報告中稱,2026年5月至7月間,與阿里巴巴/通義千問相關的活動向Claude發出超過1.51億次exchange,高峰時單日接近300萬次。同一份報告分別列出月之暗面2,300萬次以上、深度求索1,210萬次以上、智譜340萬次以上、小米40萬次以上——這是五家公司各自的獨立歸因,不是一個可以相加的總數。
這些數字本身無法單獨證明什麼。真正值得問的是:這些流量被拿去做了什麼。Anthropic的描述不只是問答紀錄——它稱在阿里巴巴的案例中,Claude輸出被轉成SFT訓練資料,用於通義千問系列模型,並協助RL環境建置與模型架構研究。這已經超過一般理解的「查資料」。
二、中國不是不會做AI
但如果因此推論「中國AI靠美國模型撐起來」,證據並不支持。
深度求索自己公開的技術路徑顯示,R1-Zero直接從base model透過大規模強化學習產生推理能力,之後再由R1自身生成資料,去蒸餾出六個較小模型——這是一條完全內部閉環的能力鏈。通義千問的旗艦模型同樣不是靠外部teacher走完整訓練:它公開的方法是自有的Long-CoT、Reasoning RL與Thinking Mode Fusion,較小模型才使用strong-to-weak distillation,而teacher是通義千問自己的模型。Kimi、小米的MiMo、智譜的GLM也都各自公開了規模可觀的自有預訓練與強化學習體系。
換句話說,中國大型AI公司已經具備相當完整的自主模型訓練能力。「沒有Claude就做不出前沿模型」這個命題,現有證據並不成立。
三、既然自己會做,為什麼還要大量取得美國模型輸出?
問題因此變成:能力已經有了,為什麼還要這麼大規模地取得Claude的輸出?
OpenAI向美國國會提交的文件,也從自己的平台觀察到深度求索及其他中國來源的蒸餾活動,並描述這類操作已不只是單純取得模型回答,而是朝更複雜的資料生成與處理流程發展。這不是轉述Anthropic的說法,而是另一家前沿模型公司自己的平台觀察。
一個合理的解釋是:即使已經有自己的teacher,使用更強的外部模型,仍可能在特定能力上降低試錯成本、取得更高品質的推理與程式資料、縮短逼近前沿的時間。但必須誠實承認一件事——這些美國模型輸出在中國公司整體訓練資料與能力提升中,究竟佔多少比重,目前沒有任何公開的比例數據,也沒有可靠的對照實驗。無法說「Claude讓通義千問提前半年」,也無法說「拿掉Claude,中國會明顯落後」。這是整個問題目前最大、也最誠實的空白。
四、美國開始封的不是晶片,而是能力
美國的政策反應,正好呼應了這個轉變。
白宮4月23日的NSTM-4寫道,美方掌握資訊顯示,主要位於中國的外國實體正在對美國前沿AI系統進行「蓄意的、工業規模的」蒸餾行動。9月8日,NSA、FBI與CISA聯合公告進一步定性:中國的AI公司正在進行工業規模的蒸餾活動,並刻意將操作分散到多個模型供應商與雲端平台,以規避單點偵測。
這代表管制的對象正在改變。晶片有工廠、封裝、出口、海關這一整套實體流程可以卡關;但模型的輸出,沒有海關。美國因此開始把防線從硬體出口管制,進一步延伸到模型存取、帳號、API、雲端平台以及蒸餾行為本身的偵測與防堵。
五、中國的答案不是停止競爭,而是提高自主程度
面對這樣的指控,中國官方的立場相當一致。商務部9月9日直接回應稱,蒸餾是「各個模型間互相學習的通行做法」,本質是中性技術手段,包括美國企業在內全球都在使用;並將美方的行動定性為把正常技術與商業問題政治化、工具化。這不是9月才出現的立場——7月27日,商務部已就美方可能以「竊取智慧財產權」為由制裁中國AI企業一事,做出類似回應。
與此同時,中國並未因此放慢自主化的腳步——第二段已經看到,幾家主要公司的自有訓練體系都在持續擴大規模。
六、真正比的是什麼?
這不是「誰完全不需要誰」——雙方都還沒有,也可能永遠不會走到那一步。真正在發生的是:中國一邊持續強化自己的訓練體系,一邊仍然有動機取得美國前沿模型的輸出;美國則一邊守住自己的技術優勢,一邊試圖讓這個優勢更難被對手取得。
過去中美AI競爭的敘事,多半停留在誰的模型更強、誰的晶片更先進。但1.51億次這個數字說明,一條新的戰線已經浮現:誰能把自己的能力留得更久,又能更快吸收對方的進步。